Nel febbraio 2003 gli uffici del primo ministro britannico pubblicano un dossier sulle armi dell'Iraq. Il documento, che deve giustificare una guerra, si rivela in parte copiato dalla tesi di uno studente. Ma a completare l'imbarazzo è un dettaglio invisibile: un esperto informatico, Richard M. Smith, apre il file e vi trova i nomi utente dei quattro funzionari che lo avevano modificato, insieme ai percorsi delle loro cartelle di lavoro (analisi di R. M. Smith). Da allora il documento è noto come il «dodgy dossier», il dossier poco pulito.
Due anni dopo, negli Stati Uniti, il serial killer BTK, sfuggito alla polizia per trent'anni, invia un dischetto a una televisione locale. Su quel dischetto, un documento Word cancellato riporta due metadati: «Christ Lutheran Church» e «Dennis». Dennis Rader viene arrestato nove giorni dopo (Wikipedia).
Entrambi i casi riguardano file Word. Ma un PDF eredita spesso queste informazioni al momento della conversione, e ne aggiunge altre. Ecco cosa può contenere senza che nulla appaia sullo schermo.
Cosa contiene un PDF, oltre alle pagine?
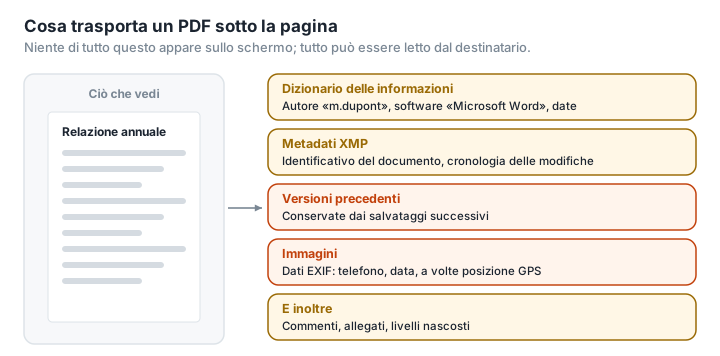
Una scheda anagrafica. Ogni PDF può contenere un dizionario delle informazioni: titolo, autore, oggetto, parole chiave, software di origine («Creator»), motore che ha prodotto il PDF («Producer»), data di creazione, data di modifica (ISO 32000). Il campo autore viene spesso compilato in automatico con il nome dell'account del computer o della licenza Office.
Una seconda scheda, più loquace. I PDF moderni contengono anche metadati in formato XMP: possono includere un identificativo univoco che accompagna il documento di versione in versione e una cronologia dei passaggi di modifica (Meridian Discovery). Cancellare la prima scheda non basta, se ci si dimentica della seconda.
Le versioni precedenti. Quando si salva un PDF modificato, molti programmi non riscrivono il file: aggiungono le modifiche in fondo. La vecchia versione resta nel file, e si può estrarre (Eclectic Light). Nel 2008 il ricercatore Didier Stevens ha ricostruito così, passo dopo passo, il lavoro dell'autore di un PDF malevolo, a partire da cinque aggiornamenti successivi conservati nel file (Didier Stevens).
I metadati delle immagini. Una foto inserita in un PDF può conservare i propri dati EXIF: modello del telefono, data e a volte coordinate GPS. Nel 2012 il fondatore dell'antivirus McAfee, allora in fuga, è stato localizzato in Guatemala a causa delle coordinate GPS di una foto pubblicata da alcuni giornalisti (NPR). La CNIL, l'autorità francese per la protezione dei dati, ricorda che le foto contengono spesso il luogo e l'ora dello scatto (CNIL).
E il resto. Commenti di revisione, allegati, livelli nascosti, dati dei moduli, testo bianco su sfondo bianco: già nel 2008 la NSA ha pubblicato una guida che elenca undici categorie di informazioni nascoste nei PDF, da verificare prima di qualsiasi pubblicazione (NSA, 2008).
Anche i professionisti della sicurezza ci cascano?
Sì, ed è stato misurato. Nel 2021 due ricercatori, Supriya Adhatarao e Cédric Lauradoux, dell'Università Grenoble Alpes e dell'Inria (l'istituto nazionale francese di ricerca in informatica), hanno analizzato 39.664 PDF pubblicati da 75 agenzie di sicurezza di 47 paesi. Secondo il loro studio, il 76% rivelava il software che li aveva prodotti, il 42% il sistema operativo e un terzo l'identità dell'autore. Solo un quarto era stato sottoposto a una pulizia, e solo una minoranza a una pulizia completa (Adhatarao e Lauradoux, 2021).
Più di recente, nel dicembre 2025, la PDF Association ha passato al setaccio le migliaia di PDF diffusi dal Dipartimento di Giustizia americano nel caso Epstein. Gli oscuramenti, in sé, erano corretti; ma i file conservavano aggiornamenti successivi e dizionari delle informazioni «orfani», invisibili nei comuni lettori PDF, che tradivano gli strumenti e la tempistica della loro preparazione (PDF Association).
Perché ti riguarda?
Un CV può rivelare il nome del tuo attuale datore di lavoro, inserito come «autore» dalla licenza Office dell'azienda. Un preventivo può rivelare quale software usi, e in quale versione. Una relazione inviata a un cliente può riportare il nome di chi l'ha scritta davvero, o la vecchia versione, prima delle correzioni. Un'attestazione composta da foto può indicare dove sono state scattate. Nessuna di queste informazioni è pericolosa in sé; ciascuna può dire più di quanto vorresti.
Per un professionista la questione è anche giuridica. Un file inviato a un cliente o pubblicato online può contenere nomi di colleghi, commenti interni o versioni precedenti. E il GDPR stabilisce un principio di minimizzazione: vanno trattati solo i dati «necessari alla finalità perseguita», secondo «la politica dello “stretto indispensabile”» (LegalPlace). Diffondere i dati nascosti di un documento significa diffonderne più del necessario.
L'ICO, l'autorità britannica per la protezione dei dati, lo riassume in una frase: «Raramente i file contengono soltanto le informazioni inserite dall'autore» (ICO).
Come vedere i metadati di un PDF?
- In un lettore PDF: il menu File › Proprietà mostra il dizionario delle informazioni (titolo, autore, software, date). È la punta dell'iceberg.
- Con Analizzare un PDF di PDFKami, per ciò che le proprietà non mostrano: lo strumento ispeziona il file nel tuo browser, senza inviarlo, e ne segnala gli allegati, i moduli e gli elementi attivi. Non legge il dizionario delle informazioni, che le proprietà del lettore mostrano già.
- Con ExifTool, uno strumento open source a riga di comando, per una lettura completa, metadati XMP compresi (ExifTool).
Come rimuovere i metadati, e le trappole da evitare
Alla fonte è più semplice. Prima di esportare in PDF, controlla le proprietà del documento nel tuo programma di videoscrittura (in Word: File › Informazioni › Verifica documento › Controlla documento). Meno informazioni all'inizio, meno da ripulire dopo.
Gli strumenti specializzati. Adobe Acrobat Pro permette, con la funzione «Sanifica documento», di rimuovere le informazioni nascoste oppure di ripulire completamente il documento (Adobe). È lo strumento che lo studio di Grenoble ha giudicato più efficace.
Tre trappole frequenti.
- Cancellare il dizionario delle informazioni ma non l'XMP, o viceversa. Spesso i due convivono.
- Salvare sullo stesso file. Molti strumenti, ExifTool compreso, aggiungono le modifiche in fondo al file: la documentazione di ExifTool avverte che le vecchie informazioni non vengono mai eliminate davvero, e raccomanda di riscrivere il file in un secondo momento (ExifTool). Lo studio di Grenoble ha dimostrato che una pulizia con ExifTool eliminava solo il riferimento ai metadati, non i metadati stessi: li ha ritrovati in tutti i PDF trattati in questo modo.
- Dimenticare le immagini. Conservano i propri metadati, che gli strumenti di pulizia dei PDF non sempre vedono.
Il metodo radicale: ricostruire il PDF a partire da immagini. Convertire ogni pagina in immagine, poi ricomporre un PDF con queste sole immagini, elimina tutto ciò che non è visibile: dizionario delle informazioni, XMP, versioni precedenti, livelli, allegati. Lo strumento open source mat2, pensato per ripulire i file, procede così per impostazione predefinita (mat2). Il prezzo da pagare: il testo non è più selezionabile, e il file è più pesante. È il principio di Oscurare PDF di PDFKami, che ricostruisce nel tuo browser un PDF composto dalle sole immagini delle pagine, senza dizionario delle informazioni né XMP; lo strumento serve anzitutto a oscurare un passaggio, e nell'articolo sul falso oscuramento dei PDF spieghiamo perché questo metodo è l'unico affidabile per farlo.
E non affidare la pulizia a chiunque. Caricare un documento su un sito online per rimuoverne le informazioni sensibili significa trasmettere quelle stesse informazioni a un terzo. Una pulizia in locale evita questo paradosso.
Glossario
Metadati: dati che descrivono un file (autore, date, software) anziché il suo contenuto.
Dizionario delle informazioni: la scheda standard di un PDF, con titolo, autore, software e date.
XMP: formato di metadati creato da Adobe, memorizzato in XML all'interno del file, che può contenere una cronologia delle modifiche.
Aggiornamento incrementale: modalità di salvataggio che aggiunge le modifiche in fondo al file senza cancellare la versione precedente.
EXIF: metadati delle foto (fotocamera, impostazioni, data, a volte posizione GPS).
Rasterizzare: convertire una pagina in immagine, il che elimina tutto ciò che non è visibile.