En février 2003, les services du Premier ministre britannique publient un dossier sur les armes irakiennes. Le document, qui doit justifier une guerre, se révèle en partie copié sur une thèse d'étudiant. Mais c'est un détail invisible qui achève de l'embarrasser : un informaticien, Richard M. Smith, ouvre le fichier et y lit les noms d'utilisateur des quatre fonctionnaires qui l'avaient modifié, ainsi que les chemins de leurs dossiers de travail (analyse de R. M. Smith). Le document s'appelle depuis le « dodgy dossier », le dossier douteux.
Deux ans plus tard, aux États-Unis, le tueur en série BTK, qui a échappé à la police pendant trente ans, envoie une disquette à une télévision locale. Un document Word effacé y porte deux métadonnées : « Christ Lutheran Church » et « Dennis ». Dennis Rader est arrêté neuf jours après (Wikipédia).
Ces deux affaires concernent des fichiers Word. Mais un PDF hérite souvent de ces informations lors de la conversion, et il en ajoute d'autres. Voici ce qu'il peut contenir sans que rien ne s'affiche à l'écran.
Qu'est-ce qu'un PDF contient, au-delà de ses pages ?
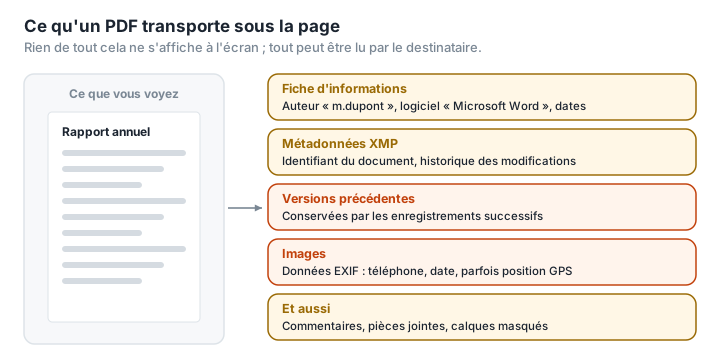
Une fiche d'identité. Chaque PDF peut porter un dictionnaire d'informations : titre, auteur, sujet, mots-clés, logiciel d'origine (« Creator »), moteur qui a produit le PDF (« Producer »), date de création, date de modification (ISO 32000). L'auteur est souvent renseigné automatiquement avec le nom du compte de l'ordinateur ou de la licence Office.
Une seconde fiche, plus bavarde. Les PDF modernes contiennent aussi des métadonnées au format XMP, qui peuvent inclure un identifiant unique suivant le document de version en version et un historique des étapes de modification (Meridian Discovery). Effacer la première fiche ne suffit pas si l'on oublie la seconde.
Les versions précédentes. Quand on enregistre un PDF modifié, beaucoup de logiciels ne réécrivent pas le fichier : ils ajoutent les changements à la fin. L'ancienne version reste dans le fichier, et peut être extraite (Eclectic Light). En 2008, le chercheur Didier Stevens a ainsi reconstitué, pas à pas, le travail de l'auteur d'un PDF malveillant à partir de cinq mises à jour successives conservées dans le fichier (Didier Stevens).
Les métadonnées des images. Une photo intégrée à un PDF peut conserver ses propres données EXIF : modèle de téléphone, date, et parfois coordonnées GPS. En 2012, le fondateur de l'antivirus McAfee, en fuite, a été localisé au Guatemala à cause des coordonnées GPS d'une photo publiée par des journalistes (NPR). La CNIL rappelle que les photos contiennent souvent la localisation et l'heure de la prise de vue (CNIL).
Et le reste. Commentaires de relecture, pièces jointes, calques masqués, données de formulaire, texte blanc sur fond blanc : la NSA a publié dès 2008 un guide recensant onze catégories d'informations cachées dans les PDF, à vérifier avant toute publication (NSA, 2008).
Même les professionnels de la sécurité s'y laissent prendre ?
Oui, et c'est mesuré. En 2021, deux chercheurs de l'université Grenoble Alpes et de l'Inria, Supriya Adhatarao et Cédric Lauradoux, ont analysé 39 664 PDF publiés par 75 agences de sécurité de 47 pays. D'après leur étude, 76 % révélaient le logiciel qui les avait produits, 42 % le système d'exploitation, et un tiers l'identité de leur auteur. Seul un quart avait fait l'objet d'un nettoyage, et une minorité seulement d'un nettoyage complet (Adhatarao et Lauradoux, 2021).
Plus récemment, en décembre 2025, la PDF Association a disséqué les milliers de PDF publiés par le ministère américain de la Justice dans l'affaire Epstein. Les passages caviardés l'étaient correctement ; mais les fichiers conservaient des mises à jour successives et des fiches d'informations « orphelines », invisibles pour les lecteurs PDF courants, qui trahissaient les outils et le calendrier de leur préparation (PDF Association).
Pourquoi est-ce important pour vous ?
Un CV peut révéler le nom de votre employeur actuel, inscrit comme « auteur » par la licence Office de l'entreprise. Un devis peut révéler le logiciel et la version que vous utilisez. Un rapport transmis à un client peut porter le nom de la personne qui l'a réellement rédigé, ou l'ancienne version, avant corrections. Une attestation composée de photos peut indiquer où elles ont été prises. Aucune de ces informations n'est dangereuse en soi ; chacune peut en dire plus que vous ne le souhaitez.
Pour un professionnel, l'enjeu est aussi juridique. Un fichier transmis à un client ou publié en ligne peut contenir les noms de collègues, des commentaires internes ou des versions antérieures. Or le RGPD pose un principe de minimisation : seules les données « nécessaires à la finalité recherchée » doivent être traitées, selon « la politique du “strict minimum” » (LegalPlace). Diffuser les données cachées d'un document, c'est en diffuser plus que nécessaire.
L'autorité britannique de protection des données le résume d'une phrase : « Les fichiers contiennent rarement les seules informations saisies par leur auteur » (ICO).
Comment voir les métadonnées d'un PDF ?
- Dans un lecteur PDF : le menu Fichier › Propriétés affiche la fiche d'informations (titre, auteur, logiciel, dates). C'est la partie émergée.
- Avec Analyser un PDF de PDFKami, pour ce que les propriétés ne montrent pas : l'outil inspecte le fichier dans votre navigateur, sans l'envoyer, et signale ses pièces jointes, ses formulaires et ses éléments actifs. Il ne lit pas la fiche d'informations, que les propriétés du lecteur affichent déjà.
- Avec ExifTool, un outil libre en ligne de commande, pour une lecture exhaustive, y compris des métadonnées XMP (ExifTool).
Comment les supprimer, et les pièges à éviter
À la source, c'est plus simple. Avant d'exporter en PDF, vérifiez les propriétés du document dans votre traitement de texte (Word : Fichier › Informations › Inspecter le document). Moins d'informations au départ, moins à nettoyer ensuite.
Les outils spécialisés. Adobe Acrobat Pro propose une fonction « Supprimer les informations masquées » et une fonction de nettoyage complet du document (Adobe). C'est l'outil que l'étude de Grenoble jugeait le plus efficace.
Trois pièges fréquents.
- Effacer la fiche d'informations mais pas le XMP, ou l'inverse. Les deux coexistent souvent.
- Enregistrer par-dessus. Beaucoup d'outils, y compris ExifTool, ajoutent les modifications à la fin du fichier : sa documentation prévient que les anciennes informations ne sont jamais réellement supprimées, et recommande de réécrire ensuite le fichier (ExifTool). L'étude de Grenoble a montré qu'un nettoyage avec ExifTool ne supprimait que la référence aux métadonnées, pas les métadonnées elles-mêmes : elle les a retrouvées dans tous les PDF ainsi traités.
- Oublier les images. Elles gardent leurs propres métadonnées, que les outils de nettoyage du PDF ne voient pas toujours.
La méthode radicale : reconstruire le PDF à partir d'images. Convertir chaque page en image, puis reconstituer un PDF à partir de ces seules images, élimine tout ce qui n'est pas visible : fiche d'informations, XMP, versions précédentes, calques, pièces jointes. L'outil libre mat2, conçu pour nettoyer les fichiers, procède ainsi par défaut (mat2). Le prix à payer : le texte n'est plus sélectionnable, et le fichier est plus lourd. C'est le principe de Caviarder PDF de PDFKami, qui reconstruit dans votre navigateur un PDF fait des seules images des pages, sans fiche d'informations ni XMP ; l'outil sert d'abord à masquer un passage, et nous expliquons pourquoi cette méthode est la seule fiable pour cela dans Le faux caviardage des PDF.
Et ne confiez pas le nettoyage à n'importe qui. Envoyer un document sur un site en ligne pour en retirer les informations sensibles revient à transmettre ces informations à un tiers. Un nettoyage local évite ce paradoxe.
Lexique
Métadonnées : données qui décrivent un fichier (auteur, dates, logiciel) plutôt que son contenu.
Dictionnaire d'informations : fiche standard d'un PDF, contenant titre, auteur, logiciel et dates.
XMP : format de métadonnées créé par Adobe, stocké en XML dans le fichier, qui peut contenir un historique de modifications.
Mise à jour incrémentale : mode d'enregistrement qui ajoute les modifications à la fin du fichier sans effacer l'ancienne version.
EXIF : métadonnées des photos (appareil, réglages, date, parfois position GPS).
Rastériser : convertir une page en image, ce qui supprime tout ce qui n'est pas visible.