En febrero de 2003, Downing Street, la oficina del primer ministro británico, publica un dosier sobre las armas de Irak. El documento, pensado para justificar una guerra, resulta estar copiado en parte de la tesis de un estudiante. Pero el golpe de gracia se lo da un detalle invisible: un informático, Richard M. Smith, abre el archivo y encuentra en él los nombres de usuario de los cuatro funcionarios que lo habían modificado, además de las rutas de sus carpetas de trabajo (análisis de R. M. Smith). Desde entonces se le conoce como el «dodgy dossier», el dosier dudoso.
Dos años después, en Estados Unidos, el asesino en serie BTK, que llevaba treinta años escapando de la policía, envía un disquete a una televisión local. En él hay un documento de Word borrado que lleva dos metadatos: «Christ Lutheran Church» y «Dennis». Dennis Rader es detenido nueve días después (Wikipedia).
Los dos casos tienen que ver con archivos de Word. Pero un PDF suele heredar esa información al convertirse, y además añade la suya. Esto es lo que puede contener sin que nada aparezca en pantalla.
¿Qué contiene un PDF, además de sus páginas?
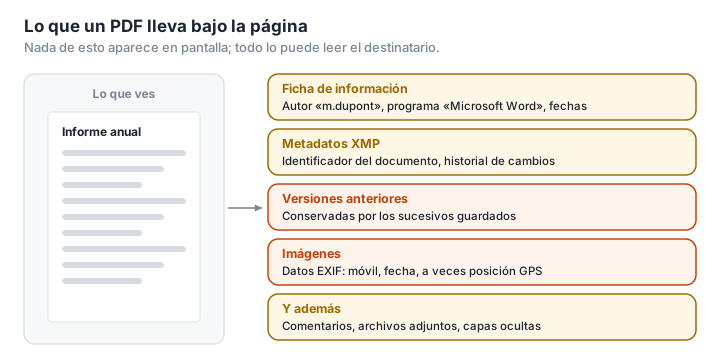
Una ficha de identidad. Todo PDF puede llevar un diccionario de información: título, autor, asunto, palabras clave, programa de origen («Creator»), motor que ha generado el PDF («Producer»), fecha de creación y fecha de modificación (ISO 32000). El campo del autor suele rellenarse automáticamente con el nombre de la cuenta del ordenador o de la licencia de Office.
Una segunda ficha, más indiscreta. Los PDF modernos también contienen metadatos en formato XMP, que pueden incluir un identificador único que sigue al documento de versión en versión y un historial de los pasos de edición (Meridian Discovery). Borrar la primera ficha no basta si te olvidas de la segunda.
Las versiones anteriores. Cuando guardas un PDF modificado, muchos programas no reescriben el archivo: añaden los cambios al final. La versión antigua sigue dentro del archivo y se puede extraer (Eclectic Light). Así fue como, en 2008, el investigador Didier Stevens reconstruyó paso a paso el trabajo del autor de un PDF malicioso, a partir de cinco actualizaciones sucesivas conservadas en el archivo (Didier Stevens).
Los metadatos de las imágenes. Una foto incrustada en un PDF puede conservar sus propios datos EXIF: modelo de móvil, fecha y, a veces, coordenadas GPS. En 2012, el fundador del antivirus McAfee, entonces en fuga, fue localizado en Guatemala por las coordenadas GPS de una foto publicada por unos periodistas (NPR). La CNIL —la autoridad francesa de protección de datos— recuerda que las fotos suelen registrar el lugar y la hora en que se tomaron (CNIL).
Y todo lo demás. Comentarios de revisión, archivos adjuntos, capas ocultas, datos de formularios, texto blanco sobre fondo blanco: ya en 2008, la NSA publicó una guía que recogía once categorías de información oculta en los PDF que había que revisar antes de publicar nada (NSA, 2008).
¿Hasta los profesionales de la seguridad caen en la trampa?
Sí, y se ha medido. En 2021, Supriya Adhatarao y Cédric Lauradoux, investigadores de la Universidad Grenoble Alpes y del Inria (el instituto público francés de investigación en informática), analizaron 39 664 PDF publicados por 75 agencias de seguridad de 47 países. Según su estudio, el 76 % revelaba el programa con el que se había generado; el 42 %, el sistema operativo, y un tercio, la identidad de su autor. Solo una cuarta parte se había sometido a una limpieza, y apenas una minoría a una limpieza completa (Adhatarao y Lauradoux, 2021).
Más recientemente, en diciembre de 2025, la PDF Association diseccionó los miles de PDF publicados por el Departamento de Justicia de Estados Unidos en el caso Epstein. La censura de los pasajes ocultos era correcta, pero los archivos conservaban actualizaciones sucesivas y fichas de información «huérfanas», invisibles en los lectores de PDF habituales, que delataban las herramientas y el calendario de su preparación (PDF Association).
¿Por qué debería importarte?
Un currículum puede revelar el nombre de la empresa en la que trabajas ahora: su licencia de Office lo ha puesto como «autor». Un presupuesto puede revelar qué programa usas, y qué versión. Un informe enviado a un cliente puede llevar el nombre de quien lo redactó en realidad, o la versión anterior a las correcciones. Un justificante hecho con fotos puede indicar dónde se tomaron. Ninguno de estos datos es peligroso en sí mismo; cada uno puede decir más de lo que querrías.
Para un profesional, el asunto tiene además una vertiente jurídica. Un archivo enviado a un cliente o publicado en internet puede contener nombres de compañeros, comentarios internos o versiones anteriores. Y el RGPD establece un principio de minimización: solo deben tratarse los datos «necesarios para la finalidad perseguida», según «la política del “mínimo imprescindible”» (LegalPlace). Difundir los datos ocultos de un documento es difundir más de lo necesario.
La autoridad británica de protección de datos lo resume en una frase: «Los archivos rara vez contienen solo la información que ha introducido su autor» (ICO).
¿Cómo ver los metadatos de un PDF?
- En un lector de PDF: el menú Archivo › Propiedades muestra la ficha de información (título, autor, programa, fechas). Es la punta del iceberg.
- Con Analizar un PDF de PDFKami, para lo que las propiedades no enseñan: la herramienta examina el archivo en tu navegador, sin enviarlo, y señala sus archivos adjuntos, sus formularios y sus elementos activos. No lee la ficha de información, que ya muestran las propiedades del lector.
- Con ExifTool, una herramienta libre de línea de comandos, para una lectura exhaustiva, metadatos XMP incluidos (ExifTool).
Cómo eliminar los metadatos de un PDF y qué trampas evitar
En el origen es más sencillo. Antes de exportar a PDF, revisa las propiedades del documento en tu procesador de textos (en Word: Archivo › Información › Comprobar si hay problemas › Inspeccionar documento). Cuanta menos información haya al principio, menos tendrás que limpiar después.
Las herramientas especializadas. Adobe Acrobat Pro ofrece una función «Quitar información oculta» y otra que limpia el documento por completo (Adobe). Es la herramienta que el estudio de Grenoble consideró más eficaz.
Tres trampas frecuentes.
- Borrar la ficha de información pero no el XMP, o al revés. Lo habitual es que convivan las dos.
- Guardar encima. Muchas herramientas, ExifTool incluida, añaden los cambios al final del archivo: su documentación advierte de que la información antigua nunca se elimina de verdad, y recomienda reescribir el archivo después (ExifTool). El estudio de Grenoble comprobó que limpiar con ExifTool solo eliminaba la referencia a los metadatos, no los metadatos en sí: los encontró en todos los PDF tratados de esa forma.
- Olvidarse de las imágenes. Conservan sus propios metadatos, que las herramientas de limpieza de PDF no siempre detectan.
El método radical: reconstruir el PDF a partir de imágenes. Convertir cada página en una imagen y rehacer después un PDF solo con esas imágenes elimina todo lo que no se ve: ficha de información, XMP, versiones anteriores, capas, adjuntos. La herramienta libre mat2, pensada para limpiar archivos, funciona así por defecto (mat2). El precio: el texto ya no se puede seleccionar y el archivo pesa más. Es el principio de Censurar PDF de PDFKami, que reconstruye en tu navegador un PDF hecho solo con las imágenes de las páginas, sin ficha de información ni XMP. La herramienta sirve ante todo para ocultar un pasaje, y explicamos por qué este método es el único fiable para hacerlo en La falsa censura en los PDF.
Y no dejes la limpieza en manos de cualquiera. Subir un documento a una web para quitarle la información sensible es entregar esa información a un tercero. Limpiarlo en local evita la paradoja.
Glosario
Metadatos: datos que describen un archivo (autor, fechas, programa) en lugar de su contenido.
Diccionario de información: la ficha estándar de un PDF, con el título, el autor, el programa y las fechas.
XMP: formato de metadatos creado por Adobe, guardado en XML dentro del archivo, que puede contener un historial de modificaciones.
Actualización incremental: forma de guardar que añade los cambios al final del archivo sin borrar la versión anterior.
EXIF: metadatos de las fotos (cámara, ajustes, fecha y, a veces, posición GPS).
Rasterizar: convertir una página en imagen, lo que elimina todo lo que no es visible.